„Die Vision, die ich meinen Kollegen erkläre, besteht darin, dass sie in der Lage sein werden, sich hundertprozentig auf unsere Daten zu verlassen, völlig unabhängig davon, woher sie stammen – das gilt auch für unsere Cloud-Daten, die in Microsoft Azure gespeichert werden.“


Anwendungsübergreifende Automatisierung und Skalierung der Datenqualität mit CLAIRE Generative AI und Informatica Headless
Automatisieren Sie Datenqualität und Observability auf Enterprise-Niveau
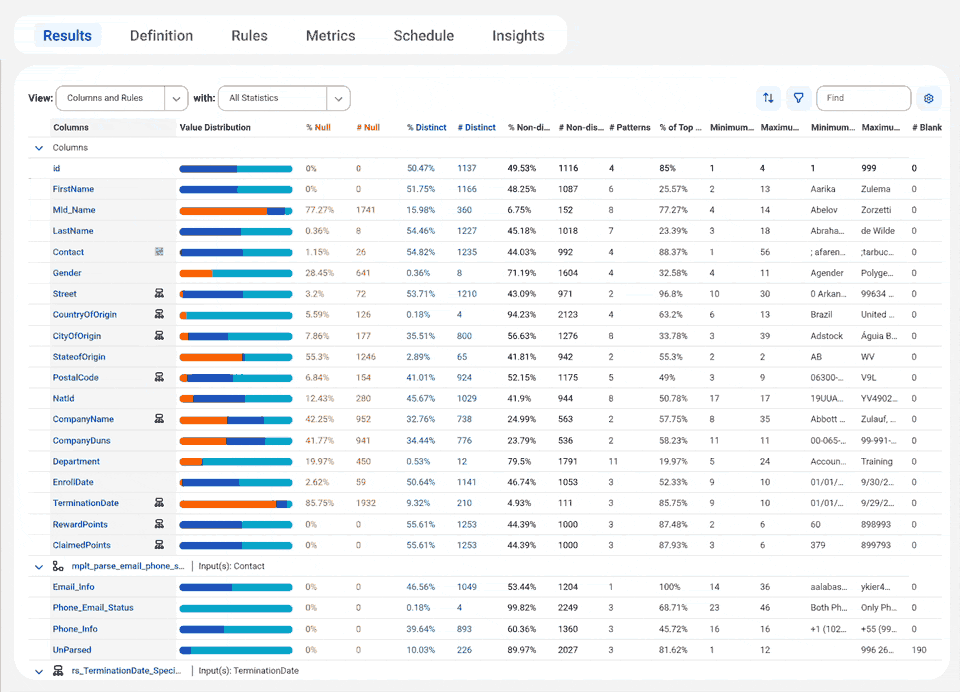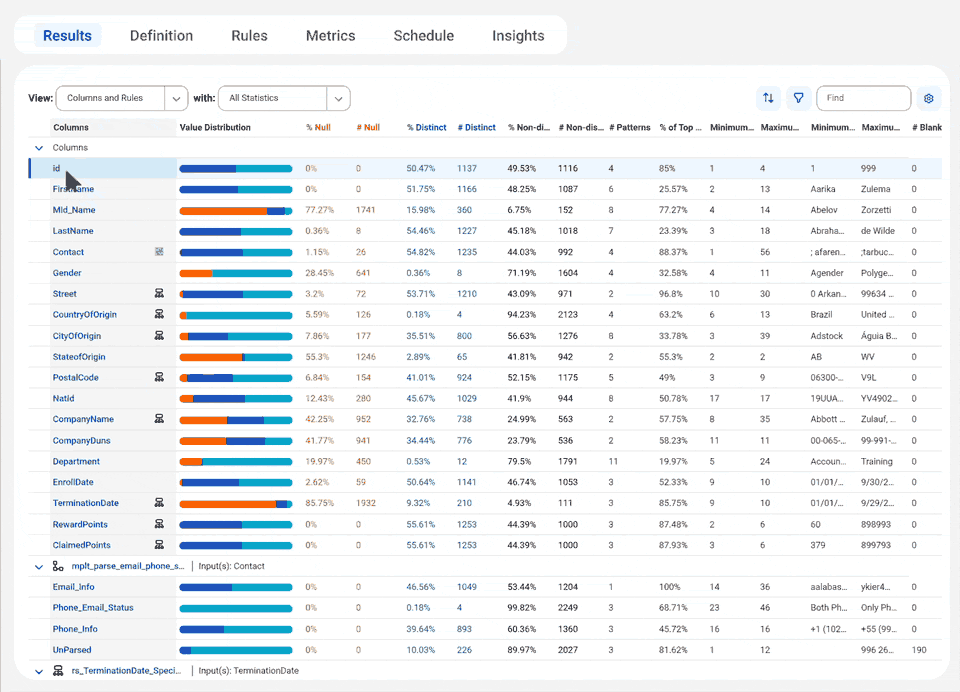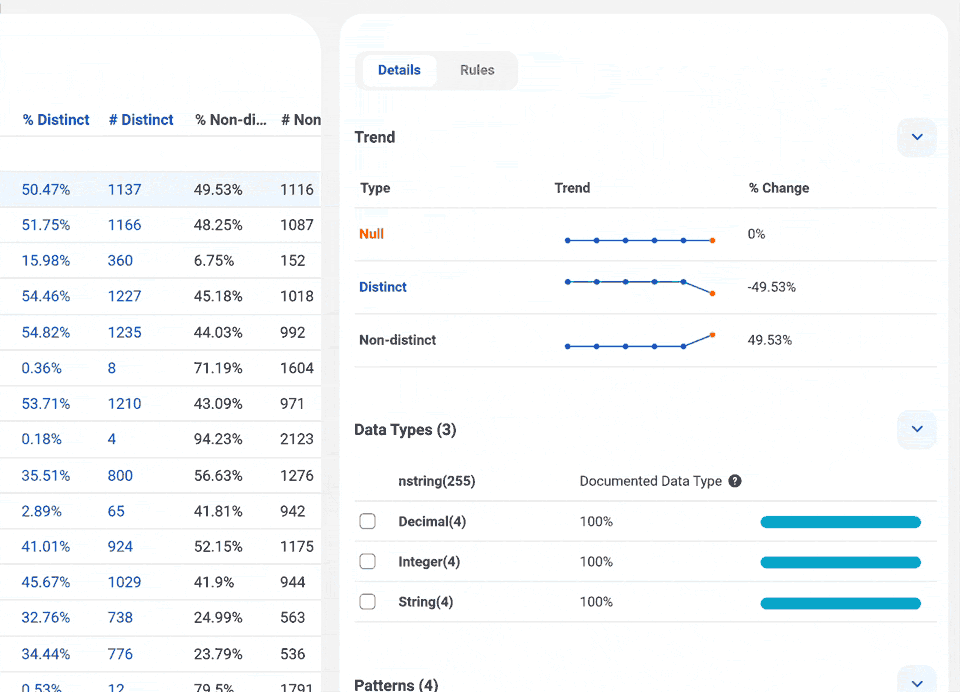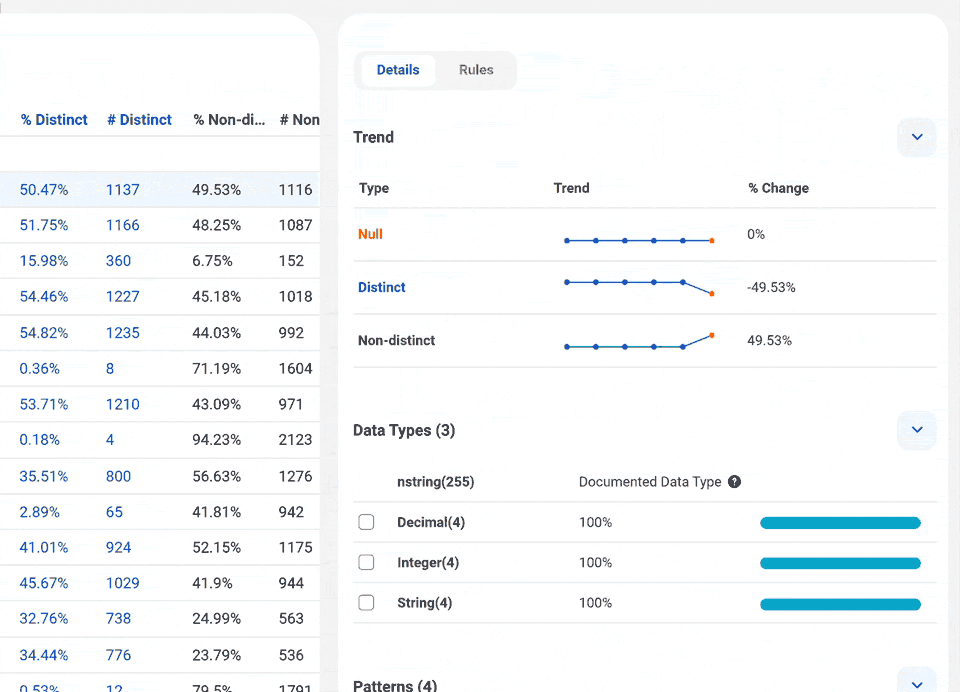
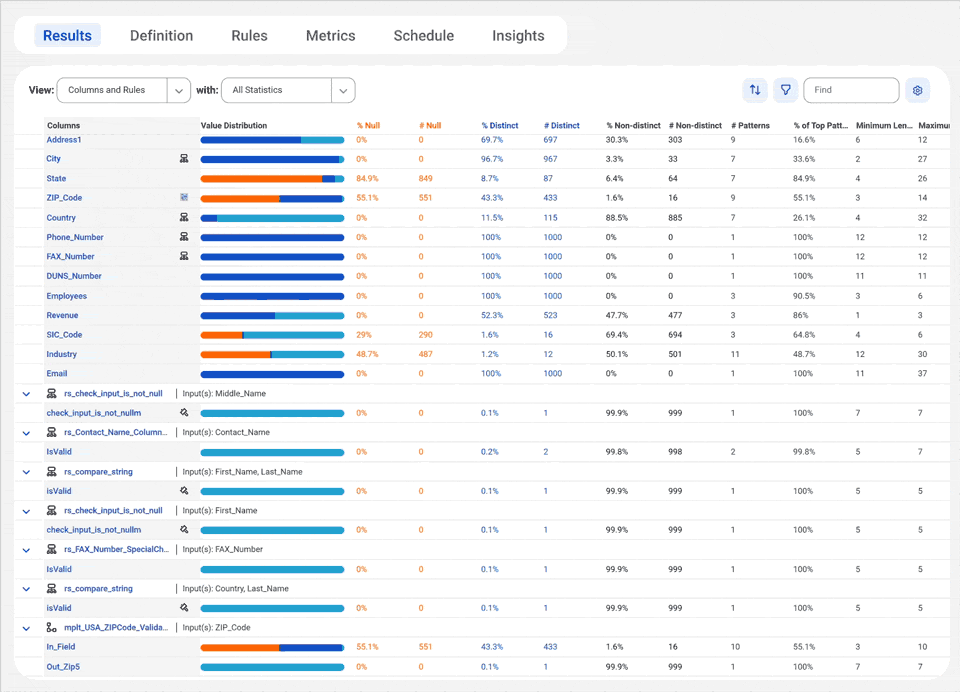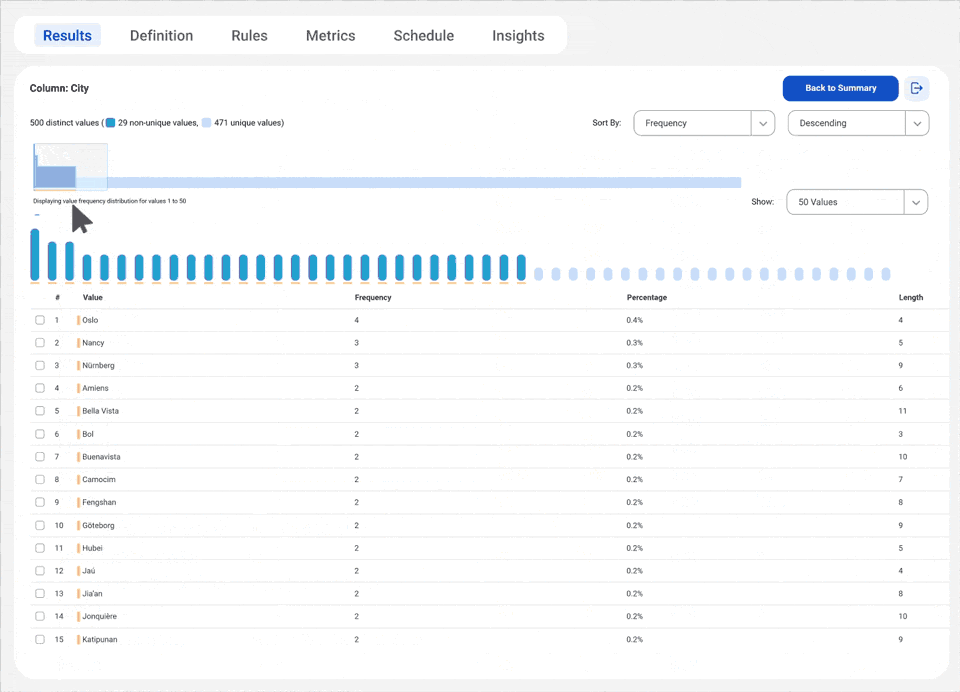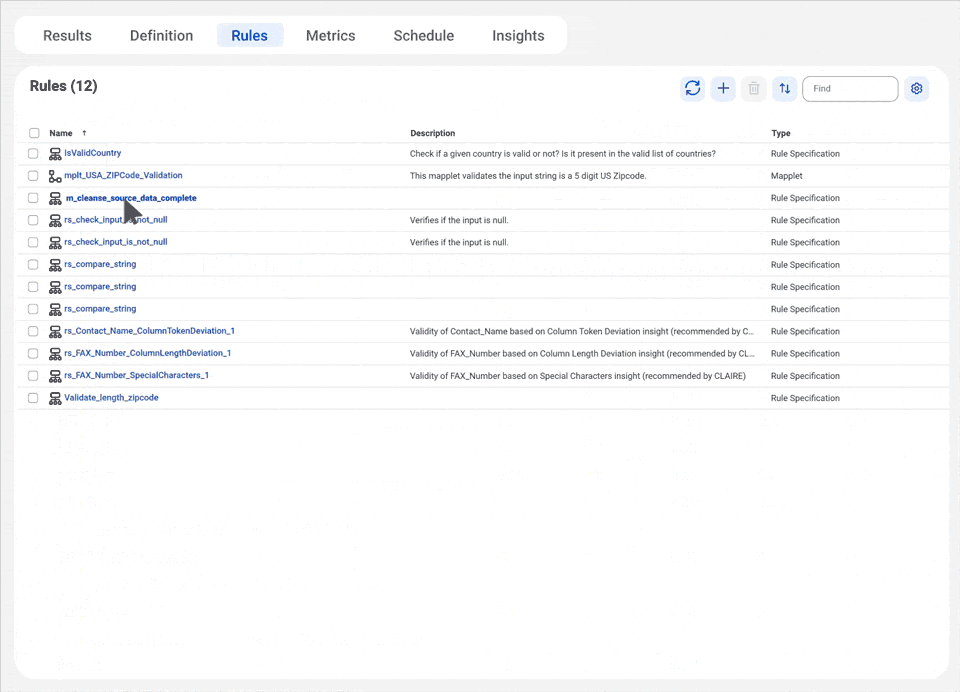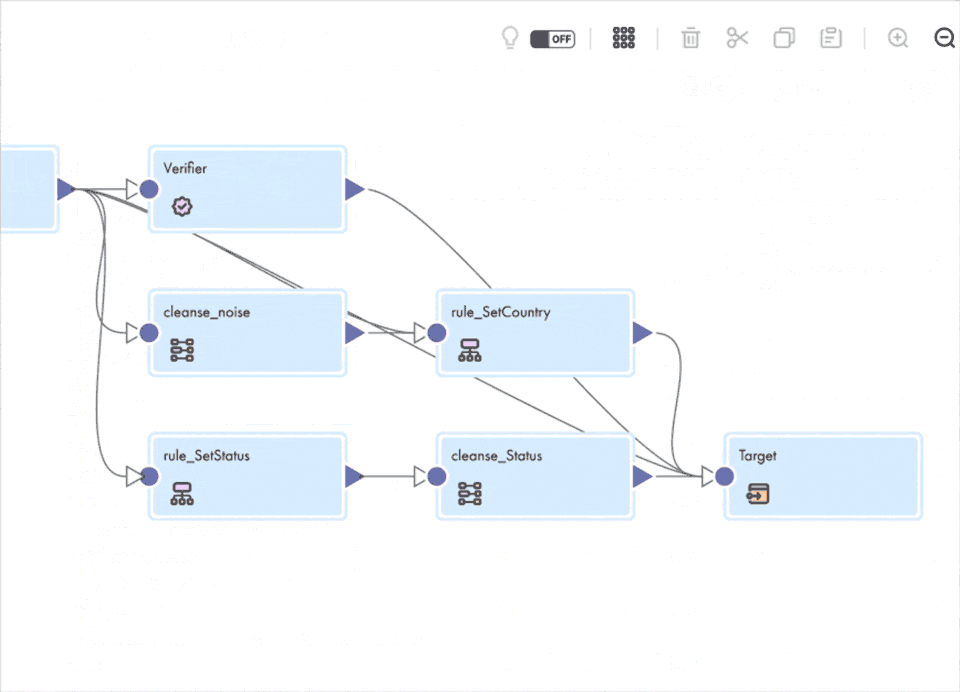
Automatisieren und skalieren Sie Data Profiling
Führen Sie kontinuierlich Data Profiling durch, um Muster, Anomalien und Qualitätsrisiken zu erkennen.
Skalierung der Datenqualität mit KI-Agenten
Automatisieren Sie mit Datenqualitäts-Agenten die Bereinigung, Standardisierung und Validierung von Unternehmensdaten, was den manuellen Aufwand reduziert und die Genauigkeit und Zuverlässigkeit in großem Maßstab erhöht.
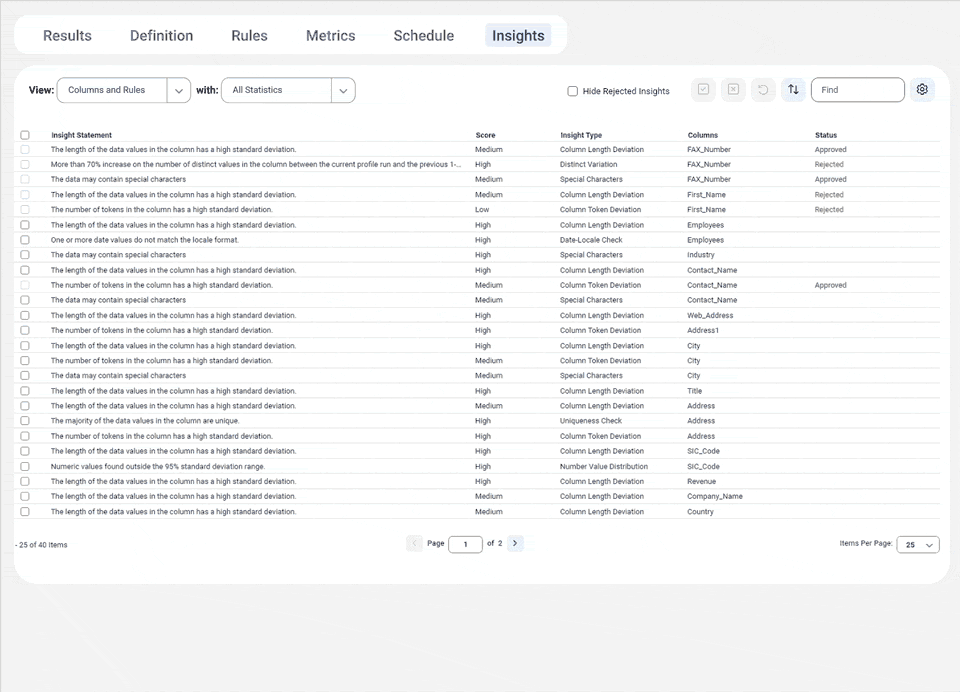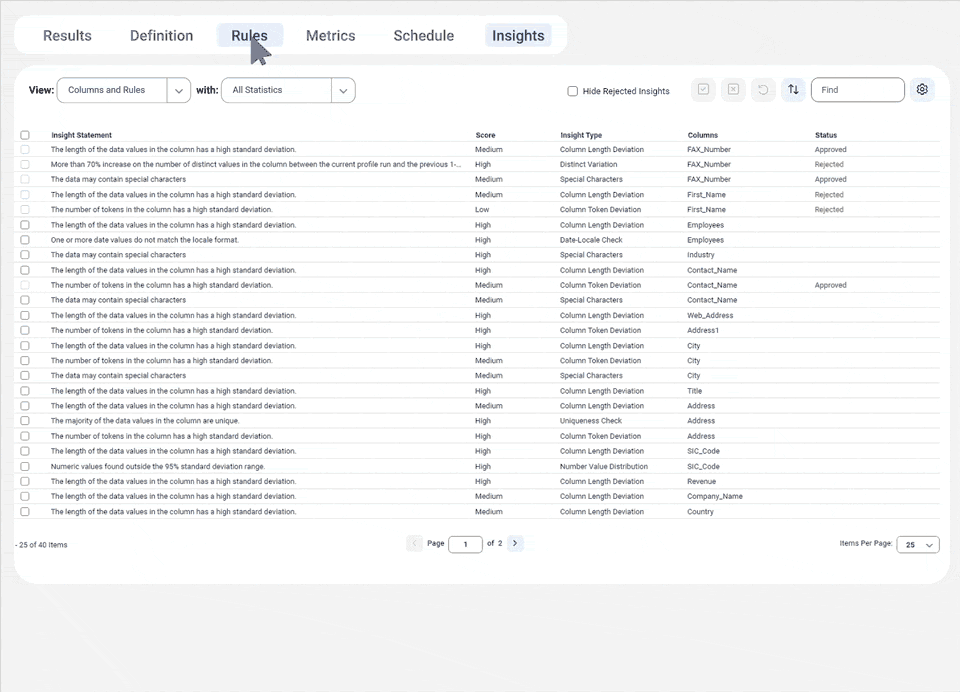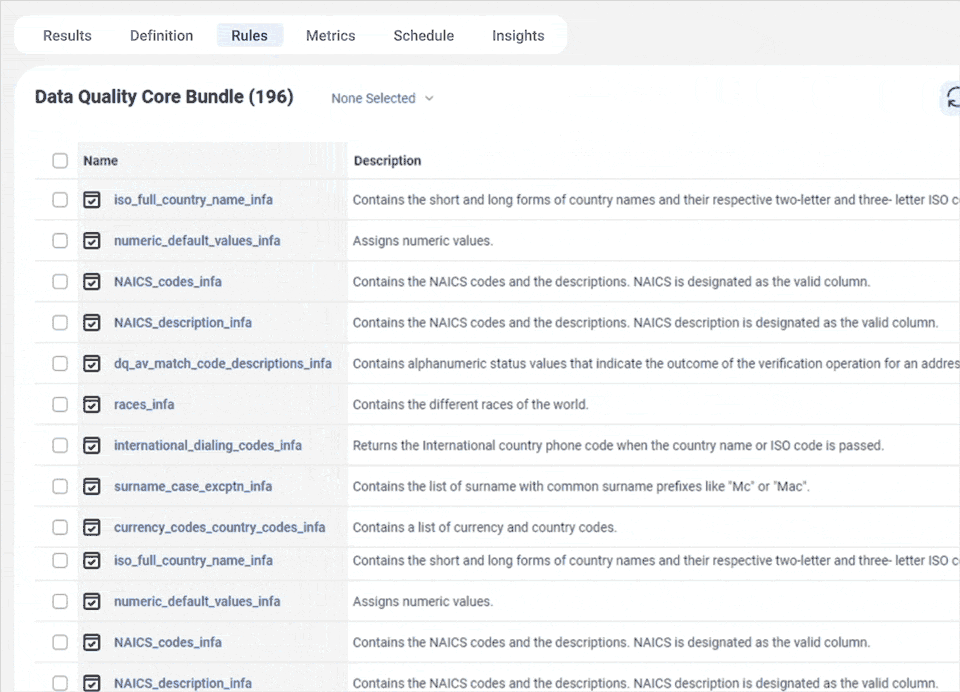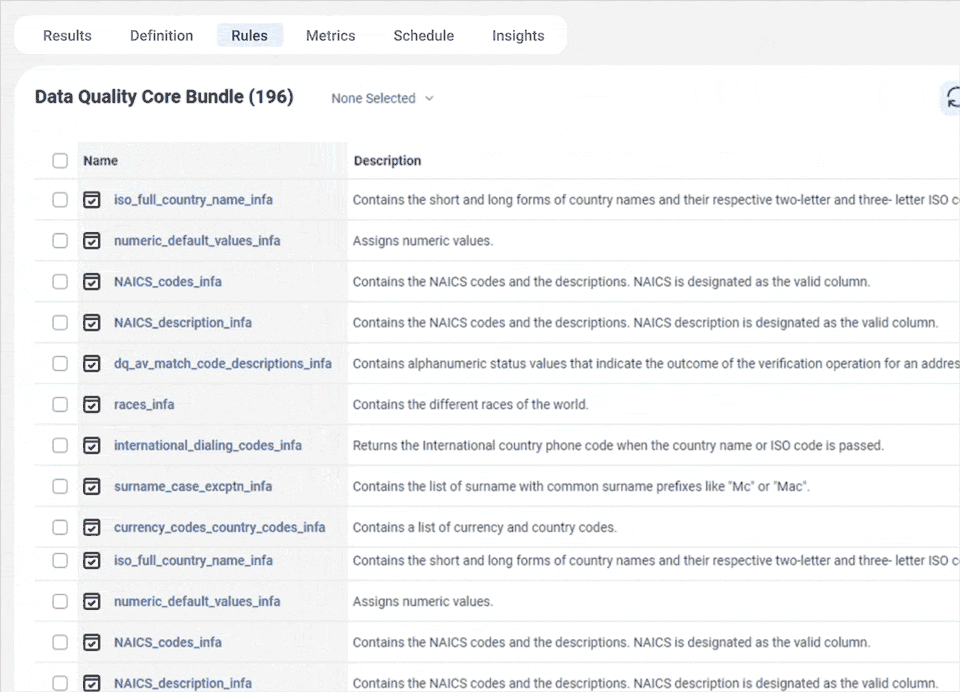
Nutzen Sie KI-gestützte Regeln und Acceleratoren
Erstellen Sie automatisch gängige Datenqualitätsregeln für beliebige Daten aus sämtlichen Quellen.
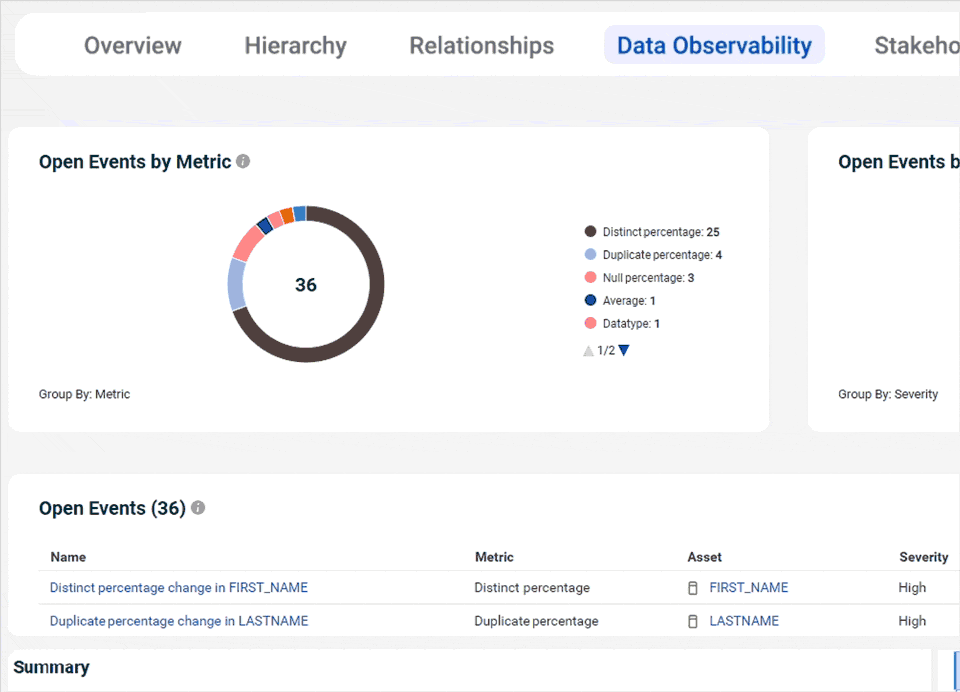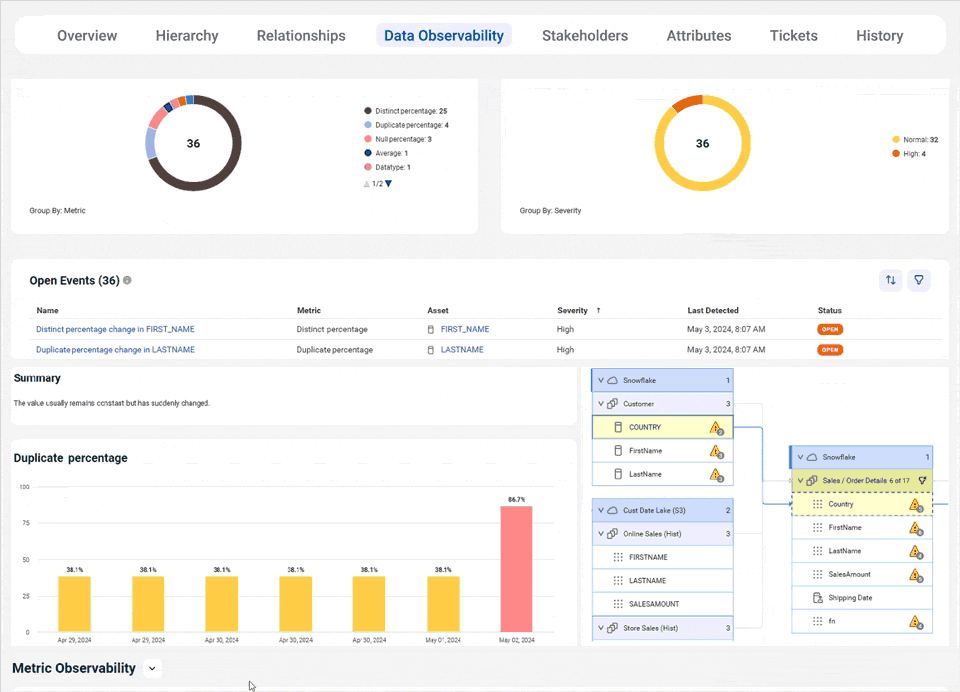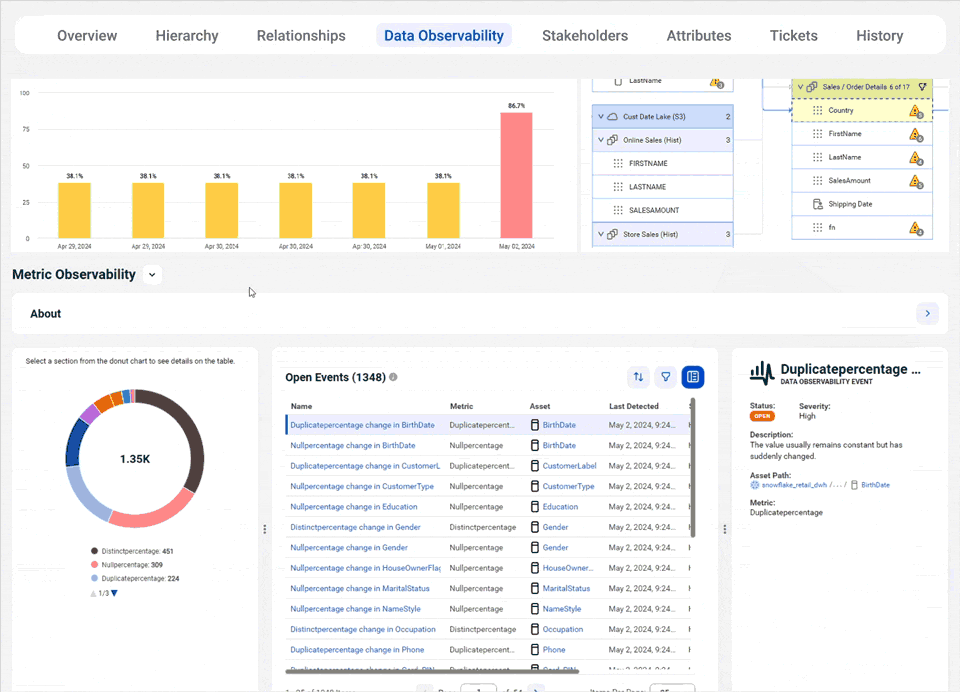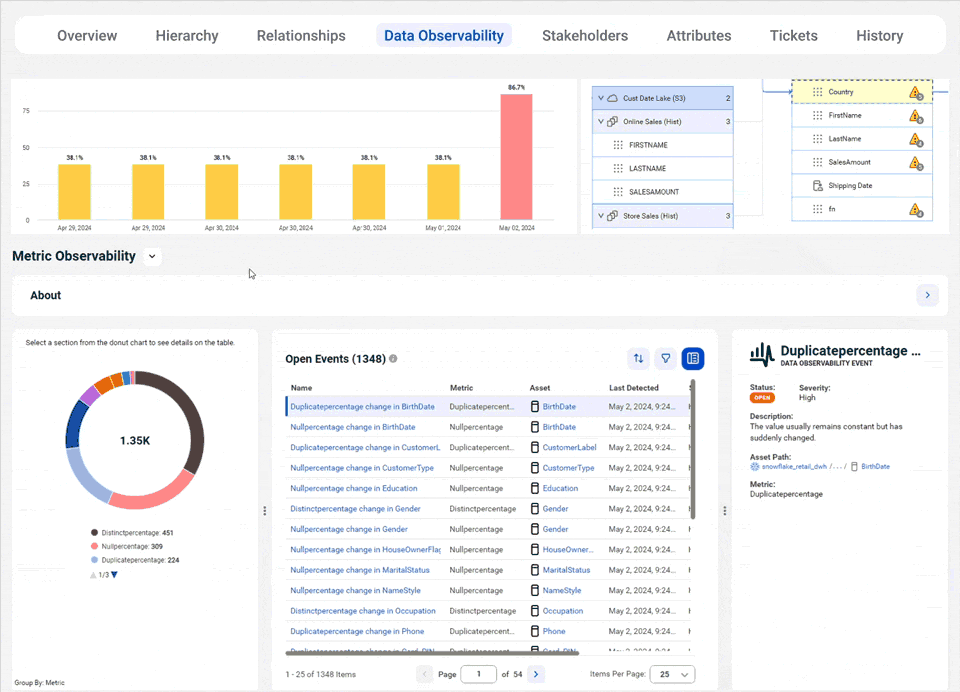
Bessere Data Observability für bessere Erkenntnisse
Erhalten Sie aus unterschiedlichen Perspektiven (Daten, Pipelines und Business) Einblick in den Zustand Ihrer Daten.
Zahlen Sie nur für das, was Sie wirklich nutzen – mit unserer flexiblen Preisgestaltung.
Mehr über damit zusammenhängende Data Quality and Observability Services
Als wichtige Komponente der KI-gestützten Informatica Intelligent Data Management Cloud (IDMC) ist Data Quality and Observability mit zahlreichen zusätzlichen Services kompatibel.
Wichtige Informationsquellen für Data Quality and Observability
E-Book
Skalieren Sie die KI-Nutzung mit zuverlässigen Daten


BLOG
KI wartet nicht: 5 Entscheidungen, die CDOs für die Datenqualität treffen müssen
2025 Gartner® Magic Quadrant™ for Augmented Data Quality Solutions
Häufig gestellte Fragen zu Data Quality and Observability
Datenqualität bezieht sich darauf, wie geeignet Daten für den beabsichtigten Zweck sind. Sie wird anhand verschiedener Aspekte ermittelt, wie Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Gültigkeit und Eindeutigkeit. Hochwertige Daten ermöglichen zuverlässige Analytics, betriebliche Effizienz und zuverlässige KI-Ergebnisse, während mangelhafte Daten zu ungenauen Erkenntnissen und fehlerhaften Entscheidungen führen können.
Data Observability bezeichnet die kontinuierliche Überwachung, Diagnose und Verwaltung des Zustands von End-to-End Datenpipelines, indem wichtige Metriken nachverfolgt werden, wie Aktualität, Menge, Verteilung, Schema-Änderungen und Lineage. Data Observability stellt automatisierte Telemetrie, Erkennung von Anomalien in Echtzeit und Ursachenanalyse bereit, die erforderlich sind, um die Datenqualität in großem Umfang kontinuierlich zu messen, zu schützen und zu wahren.
Datenqualität ist für zuverlässige Geschäfts- und KI-Ergebnisse unerlässlich. Mangelhafte Daten können Analytics verzerren, Abläufe verlangsamen, Kosten erhöhen und das Vertrauen in KI-generierte Erkenntnisse untergraben. Da Unternehmen ihren Einsatz von KI und Automatisierung ausweiten, ist es wichtig, dass eine hohe Datenqualität sichergestellt wird, um die Entscheidungsfindung zu beschleunigen, Customer Experiences zu verbessern und Risiken reduzieren zu können.
Zu gängigen Datenqualitätsproblemen gehören:
- Genauigkeit – Daten spiegeln nicht die Werte der realen Welt wider
- Vollständigkeit – fehlende Datensätze, Attribute oder Werte
- Konsistenz – widersprüchliche Informationen in verschiedenen Systemen
- Duplizierung – mehrere Datensätze, die dieselbe Entität bezeichnen
- Validität – Daten, die gegen festgelegte Formate, Regeln oder Standards verstoßen
- Fehlende Eindeutigkeit – es ist nicht möglich, zuverlässig zwischen Datensätzen zu unterscheiden
- Probleme mit der Aktualität – veraltete Daten, die die aktuellen Bedingungen nicht mehr widerspiegeln
Diese Probleme treten oft bei Initiativen zu Systemintegration, Cloud-Migration oder Anwendungsmodernisierung auf. Wenn sie nicht behoben werden, können sie sich negativ auf Analytics, Betriebsabläufe und KI-Performance auswirken.
Die Verbesserung der Datenqualität führt zu messbarem Business Value, darunter:
- Bessere KI- und Analytics-Ergebnisse – zuverlässige Daten führen zu zuverlässigen Erkenntnissen und Prognosen
- Schnellere Entscheidungsfindung – Teams können dank genauer Informationen zuverlässig agieren
- Höhere Produktivität – Teams verbringen weniger Zeit mit dem Ermitteln, Beheben und Abgleichen von Datenproblemen
- Geringere Betriebskosten – weniger Nacharbeit und weniger Fehler in nachgelagerten Systemen
- Bessere Customer Experiences – überragende Personalisierung und hervorragender Service durch genaue, aktuelle Daten
Mit steigender KI-Nutzung ist die Datenqualität zu einer Grundvoraussetzung für skalierbare, zuverlässige KI-Initiativen geworden.
KI ist nur so gut wie die Daten, auf denen sie basiert. Unvollständige, inkonsistente, veraltete oder doppelte Daten führen zu Bias, unzureichenden Empfehlungen und ungenauen Prognosen. So wird das Vertrauen in die Systeme, in die Unternehmen investieren, untergraben. Durch die kontinuierliche Verbesserung der Datenqualität können Unternehmen KI-Anwendungen entwickeln, die auch in großem Umfang zuverlässig agieren. Gleichzeitig können sich Führungskräfte bei ihrem Vorgehen auf den Output der KI verlassen.


