“Descobrimos que o Cloud Data Integration da Informatica era a solução de integração de dados mais flexível e que seria a mais fácil para nossos usuários corporativos adotarem. “Começamos a utilizá-la para o caso de uso simples de fazer backup de possíveis novos clientes do Salesforce para o nosso banco de dados e rapidamente ela se tornou a espinha dorsal do nosso ecossistema de dados de marketing.”

Utilize o Informatica Headless e a CLAIRE® AI sem custo adicional
Impulsione sua empresa agêntica com dados prontos para IA
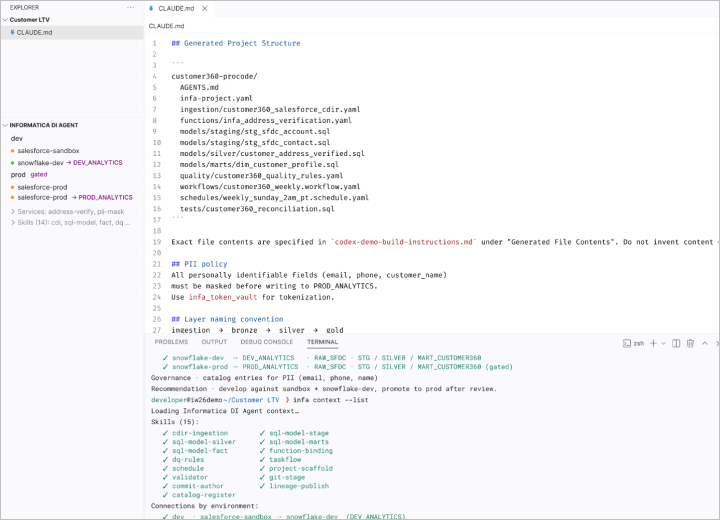
Crie em qualquer lugar com recursos headless
Crie, valide e implante pipelines de dados prontos para IA a partir de qualquer ambiente de desenvolvimento. Permita que desenvolvedores pro-code e low-code trabalhem nas ferramentas de sua preferência, incluindo Claude e outros ambientes compatíveis com MCP.
Automatize pipelines com IA
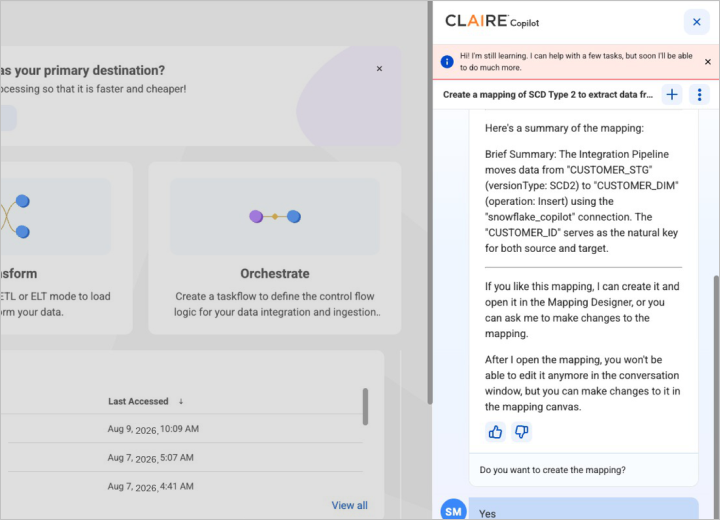
Aumente a produtividade com o CLAIREⓇ Copilot for Data Integration por meio da geração e do resumo de pipelines assistidos por IA. Use linguagem natural para automatizar tarefas rotineiras de engenharia de dados com facilidade.
Forneça dados prontos para IA
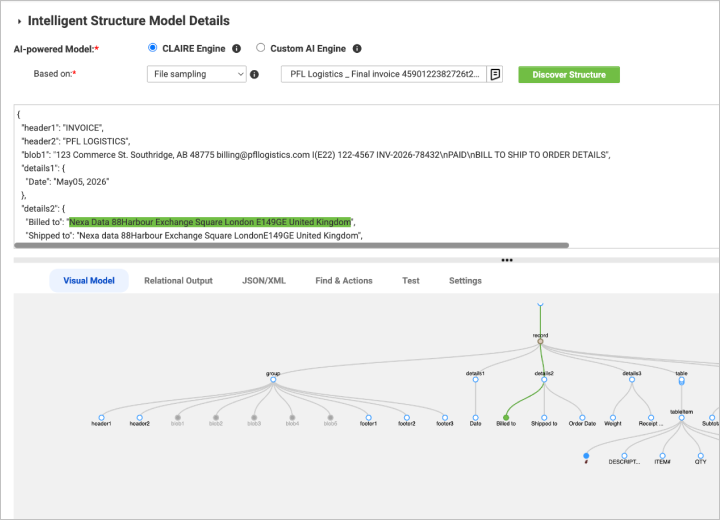
Impulsione suas iniciativas de IA agêntica transformando dados não estruturados complexos em contexto pronto para IA, para uso em bancos de dados vetoriais e arquiteturas RAG.
Impulsione arquiteturas de dados modernas
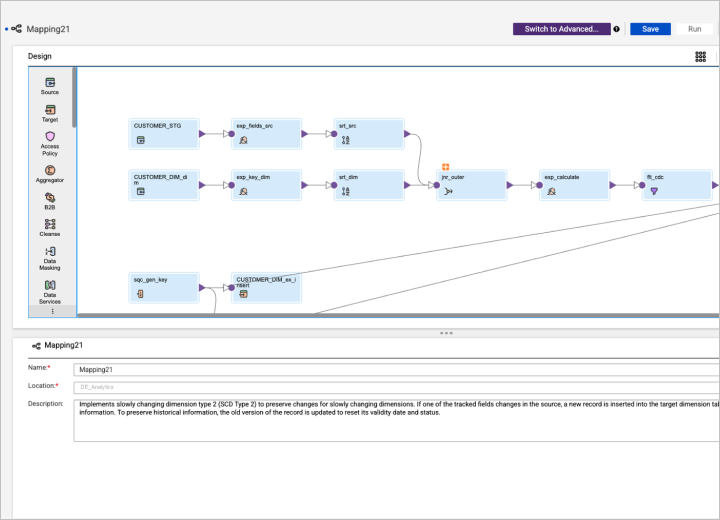
Faça a ingestão de dados em data warehouses e data lakes na nuvem com ELT/ETL de alto desempenho, replicação de dados ou captura de alterações de dados. Aproveite arquiteturas modernas com suporte a formatos de tabela abertos.
Pague apenas pelo que usar com nossos preços flexíveis.
Explore os serviços de integração de dados relacionados em nuvem
Como uma das principais partes do Informatica Intelligent Data Management Cloud (IDMC) equipado com IA, a integração e engenharia de dados funciona com diversos serviços complementares.
Faça centenas de conexões de maneira fácil e contínua.
Principais recursos de integração e engenharia de dados
RELATÓRIO DE ANALISTA
Gartner® Magic Quadrant™ de 2025 para Ferramentas de integração de dados


A pergunta de 22 milhões de dólares: a sua integração de dados está gerando retorno sobre o investimento?
Acelere a análise moderna e a IA com integração e engenharia de dados na nuvem

Simplifique a integração de dados com ELT na nuvem
Perguntas frequentes sobre integração e engenharia de dados da Informatica
A integração de dados na nuvem é o processo de consolidação e sincronização de dados provenientes de fontes distintas, como sistemas locais, aplicativos na nuvem e plataformas de terceiros, em um ambiente centralizado e unificado na nuvem. Ao automatizar os pipelines de dados e eliminar os silos de informação, ela permite realizar análises em tempo real, compartilhar dados de forma integrada e estabelecer uma única fonte de verdade em toda a organização.
A integração e engenharia de dados da Informatica ajudam a automatizar tarefas de rotina com ferramentas de baixo código/sem código, reduzindo o tempo e os recursos necessários.
A integração e engenharia de dados da Informatica oferecem visibilidade das cargas de trabalho dos pipelines com recursos de ajuste automático.
A integração e engenharia de dados da Informatica oferecem suporte a estrutura de dados, malha de dados e data lakehouse, entre outros.
A integração e engenharia de dados da Informatica oferecem suporte à replicação de dados e à change data capture (CDC) por meio do Informatica Cloud Mass Ingestion.
A principal diferença entre ETL (Extract, Transform, Load, Extrair, Transformar, Carregar) e ELT (Extract, Load, Transform, Extrair, Carregar, Transformar) está na ordem e no local onde o processamento dos dados é realizado. No processo de ETL, os dados brutos são transformados em um servidor de preparação separado antes de serem carregados no sistema de destino, o que é ideal para requisitos rigorosos de conformidade e infraestruturas legadas. Por outro lado, o ELT carrega os dados brutos diretamente no destino, normalmente primeiro em um data warehouse moderno na nuvem, e depois os transforma usando a capacidade de computação na nuvem do sistema de destino. Isso permite uma ingestão de dados significativamente mais rápida, maior flexibilidade e menores custos de processamento para Big Data.


